

Gemini 3.8 Flash TTS ra mắt: Sao chép giọng từ 30 giây âm thanh, hỗ trợ hơn 2.000 giọng
Tạo giọng nói bằng câu lệnh, hơn 2.000 lựa chọn sẵn có
Gemini 3.8 Flash TTS được Google định hướng cho các tác vụ tạo giọng và thiết kế nhân vật, trong khi Gemini 3.8 Flash-Lite TTS tối ưu cho nhu cầu tạo âm thanh với khối lượng lớn như lồng tiếng, sản xuất nội dung và xây dựng trợ lý giọng nói.
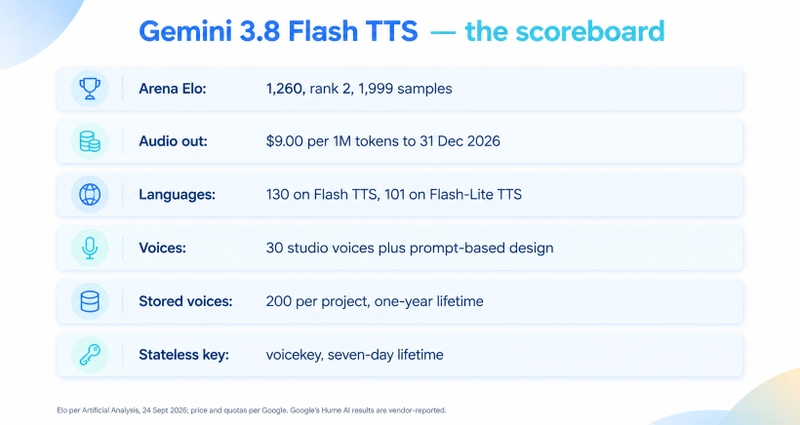
Điểm đáng chú ý trên Gemini 3.8 Flash TTS là khả năng tạo một giọng nói mới hoàn toàn từ mô tả bằng ngôn ngữ tự nhiên. Người dùng có thể tùy chỉnh vai trò, giọng địa phương và đặc điểm giọng đọc trên hơn 100 ngôn ngữ và phương ngữ.
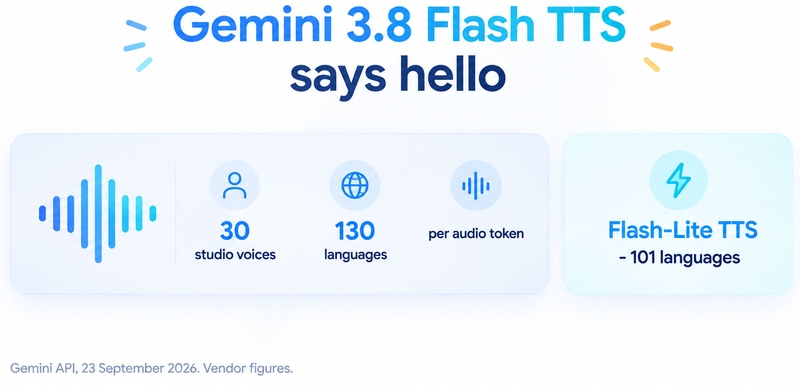
Google đồng thời cung cấp hơn 2.000 giọng nói sẵn sàng cho môi trường sản xuất, bao gồm nhiều biến thể theo khu vực như tiếng Tây Ban Nha Mexico, tiếng Pháp Quebec hay tiếng Anh Scotland.
Thư viện ban đầu gồm 30 giọng gốc và có thể mở rộng bằng giọng tùy chỉnh. Người dùng cũng có thể lưu và quản lý các giọng đã tạo để tiếp tục sử dụng trong nhiều dự án khác nhau. Trong thời gian tới, Google sẽ bổ sung tính năng Voice Remixing, cho phép điều chỉnh âm sắc, cao độ, tốc độ nói và giọng địa phương của một giọng có sẵn bằng câu lệnh.
Sao chép giọng nói từ đoạn âm thanh 30 giây
Gemini 3.8 Flash TTS hỗ trợ tái tạo đặc trưng giọng nói từ một đoạn âm thanh dài khoảng 30 giây. Tính năng này chỉ áp dụng với giọng của chính người dùng hoặc giọng mà họ có quyền sử dụng.
Để tạo bản sao giọng nói, Google yêu cầu một bản ghi xác nhận bằng lời của chủ sở hữu giọng nói, đồng thời người nói trong bản xác nhận phải trùng khớp với mẫu tham chiếu.
Các nội dung âm thanh tạo ra từ Gemini Audio cũng được nhúng watermark SynthID. Riêng tính năng sao chép giọng nói còn sử dụng thông tin xác thực C2PA nhằm tăng khả năng nhận diện nguồn gốc nội dung.
Điều khiển cách đọc theo từng câu, hỗ trợ hội thoại hai người
Sau khi chọn giọng, Gemini 3.8 Flash TTS và Flash-Lite TTS cho phép người dùng điều chỉnh cách thể hiện của từng câu thông qua các chỉ dẫn viết trực tiếp trong kịch bản.
Hệ thống có thể xử lý những yêu cầu liên quan đến diễn xuất, tốc độ, sắc thái, thay đổi phương ngữ hay mức độ biểu cảm. Google cũng thiết kế hai mô hình để duy trì chất lượng giọng, nhịp nói và âm sắc nhân vật trong các nội dung kéo dài nhiều giờ, đồng thời hạn chế hiện tượng giọng bị thay đổi theo thời gian.
Bộ đôi TTS mới còn hỗ trợ dựng hội thoại hai người từ một kịch bản duy nhất. Mỗi nhân vật vẫn giữ giọng riêng và luân phiên hội thoại tự nhiên.
Người viết kịch bản có thể chèn trực tiếp các chỉ dẫn phi ngôn ngữ như <laughs>, <sigh>, <gasp> hoặc phản hồi ngắn như |mhm|, |yeah| để tạo cảm giác hội thoại tự nhiên hơn.
Gemini 3.8 Flash TTS đứng đầu benchmark thiết kế giọng
Theo kết quả Google công bố, Gemini 3.8 Flash TTS đạt 71,4 điểm tổng thể và 60,8 điểm ở khả năng mô phỏng giọng địa phương trên Voice Design Benchmark của Hume AI, qua đó đứng đầu bảng xếp hạng này.
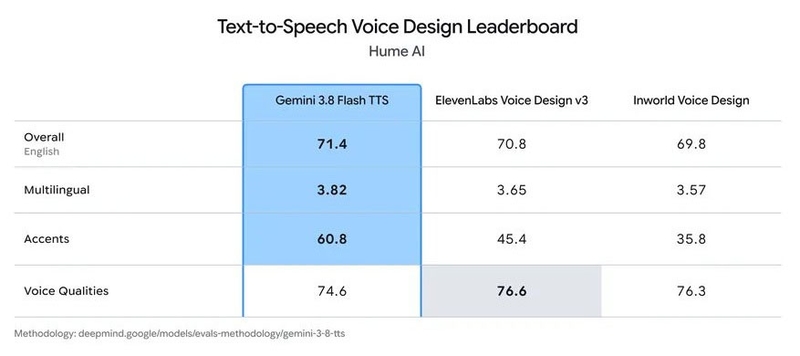
Trên Overall Quality Index của Hume AI, Gemini 3.8 Flash TTS đứng đầu, còn Gemini 3.8 Flash-Lite TTS xếp thứ hai.
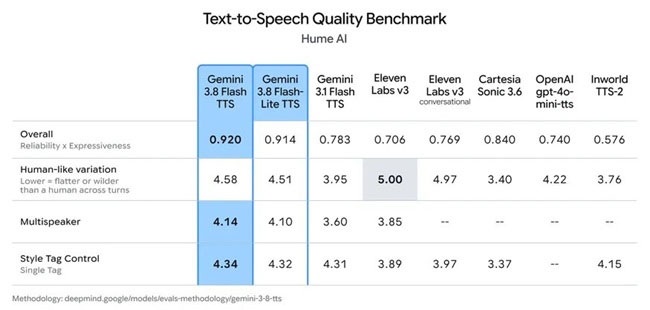
Google cũng ghi nhận sự cải thiện về khả năng xử lý nội dung dài và điều khiển kịch bản hai người so với Gemini 3.1 Flash TTS.
Trong các bài đánh giá ẩn danh trên Voice Arena, hai mô hình mới đạt vị trí cao ở nhiều ngôn ngữ, gồm tiếng Nhật, tiếng Bồ Đào Nha Brazil, tiếng Việt, tiếng Ả Rập chuẩn hiện đại, tiếng Tây Ban Nha Mexico và tiếng Hindi. Tổng số ngôn ngữ được hỗ trợ vượt mốc 100.
Google tăng lớp bảo vệ cho nội dung giọng nói AI
Song song với việc mở rộng khả năng tạo và sao chép giọng nói, Google triển khai thêm các biện pháp bảo vệ liên quan đến chủ sở hữu giọng, danh tính và tính minh bạch của nội dung.
Mọi đoạn âm thanh do Gemini Audio tạo ra đều được nhúng SynthID trực tiếp vào đầu ra. Google sử dụng watermark này để hỗ trợ nhận diện nội dung giọng nói do AI tạo và giảm nguy cơ lợi dụng công nghệ cho mục đích phát tán thông tin sai lệch.
Có mặt trên Google AI Studio, Gemini API và Google Vids
Google AI Studio đã bổ sung khu vực thử nghiệm dành cho các tính năng tạo giọng mới. Nhà phát triển có thể thiết kế giọng từ câu lệnh, sao chép giọng của chính mình và đưa các giọng này vào trình biên tập kịch bản hai người để điều khiển cách đọc theo từng câu.
Tính năng sao chép giọng trên Google AI Studio hiện chưa được cung cấp tại Illinois, Texas, Khu vực Kinh tế châu Âu, Anh, Thụy Sĩ và Ấn Độ.
Về khả năng tích hợp, Gemini API hiện hỗ trợ các nền tảng như Agora, LiveKit, Pipecat và Vercel. Figma, HeyGen, Linguana, Wondercraft, 99.co và Ollang cũng đang đưa các mô hình TTS mới vào những ứng dụng như lồng tiếng đa ngôn ngữ, bản địa hóa nội dung theo giọng vùng miền và trợ lý hội thoại bằng giọng nói.
Gemini 3.8 Flash TTS bắt đầu được triển khai cho nhà phát triển thông qua Gemini API và Google AI Studio, trong khi người dùng phổ thông có thể tiếp cận qua Gemini Notebook. Phiên bản dành cho doanh nghiệp sẽ được bổ sung trên Gemini Enterprise trong thời gian tới.
Gemini 3.8 Flash-Lite TTS cũng được phát hành trên Gemini API và Google AI Studio, đồng thời có mặt trên Google Vids dành cho người dùng phổ thông. Phiên bản doanh nghiệp sẽ được triển khai sau qua Gemini Enterprise.
Hãy theo dõi FPT Shop thường xuyên để cập nhật nhanh các tin tức và xu hướng công nghệ mới. Hiện FPT Shop đang ưu đãi nhiều mẫu laptop với giá tốt, cấu hình mạnh và hỗ trợ trả góp linh hoạt, giúp bạn dễ dàng nâng cấp thiết bị phù hợp cho học tập, làm việc và trải nghiệm các công cụ AI.
Xem thêm:
- So sánh ChatGPT và Gemini chi tiết nhất: Đâu là công cụ AI phù hợp với bạn hơn?
- Gemini 3.6 Flash là gì? Cập nhật đầy đủ giá API và những thay đổi quan trọng nhất so với Gemini 3.5 Flash
Nguồn: FoneArena


